 Paco y Nico
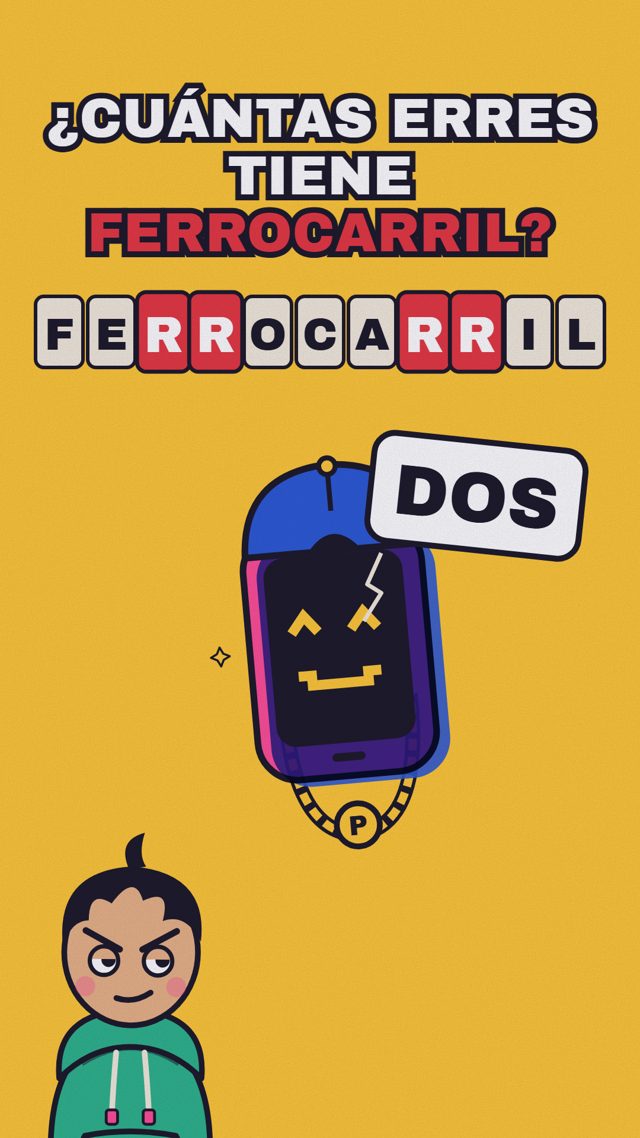
Nico pregunta cuántas erres tiene «ferrocarril». Paco dice que dos. Con total seguridad.
Un token es el trozo mínimo de texto con el que trabaja un modelo de lenguaje: una palabra, un pedazo de palabra o un signo. El tokenizador corta el texto en tokens y cambia cada uno por un número de su vocabulario. El modelo solo ve esos números.
Por qué no trabaja con letras
Si el modelo leyera letra a letra, cada texto sería larguísimo y aprender sería mucho más lento. Si leyera solo palabras enteras, necesitaría un vocabulario infinito. Los tokens son el término medio: los trozos que más se repiten en los textos se quedan juntos. El de GPT-4o tiene unos 200.000.
Entonces, ¿por qué falla?
Para el modelo, 855 es solo un número: no «sabe» que dentro hay una f, una e y una r. Para contar erres tendría que recordar cómo se deletrea cada ficha, y eso lo ha aprendido solo a medias. Por eso puede escribir un poema perfecto y fallar en algo que un niño de siete años hace bien.
El truco
Pídele que lo deletree primero, letra por letra, y luego que cuente. Al escribir las letras sueltas, cada una se convierte en su propio token y ya puede verlas.